如果你还在用”文字进、文字出”的方式理解 AI,那 2026 年的局面可能要刷新你的认知了。这一年,多模态 AI 已经不只是实验室里的概念,而是切切实实地走进了日常工作流。
它能看懂图片、听懂语音、理解视频,还能把文字、图像、声音混在一起理解。这意味着什么?意味着一个人靠 AI 就能完成过去需要摄影、剪辑、配音、设计多个工种配合的创作任务。
一、多模态 AI 到底是什么
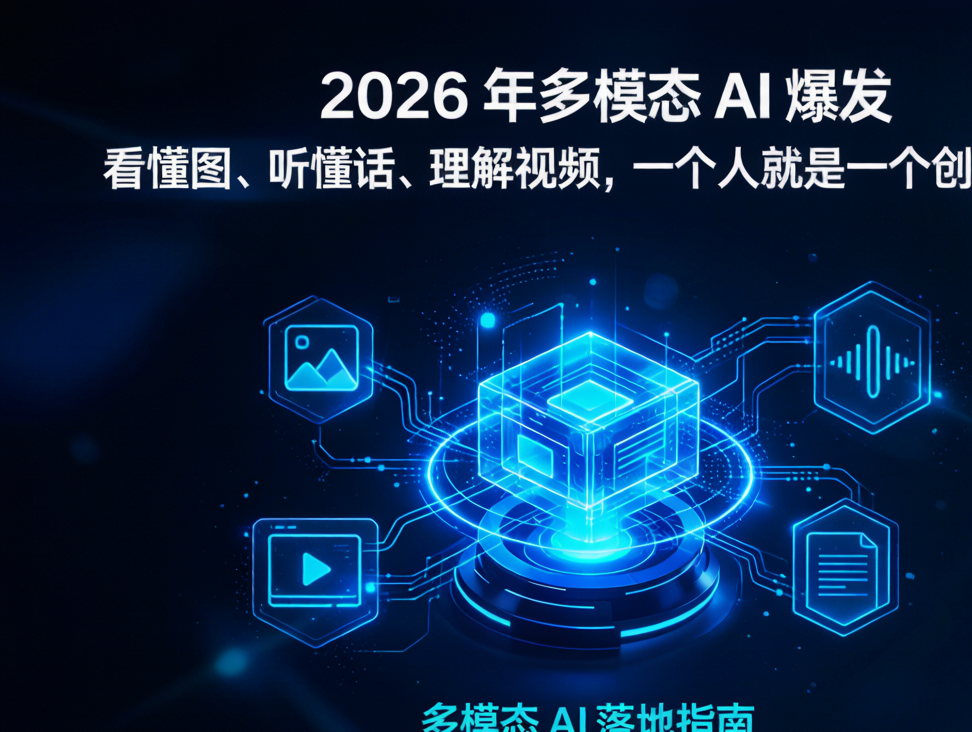
单模态 AI 只会处理一种信息。比如早期的 GPT 只处理文字,Stable Diffusion 只生成图片。多模态 AI 则能同时处理并理解多种信息:文字、图像、音频、视频。
更关键的是,它不是分别处理再拼接,而是能在不同模态之间建立关联。你给它一张图,它能用文字描述出来;你给它一段文字,它能生成对应的图;你给它一个视频,它能提炼出关键帧和摘要。
二、2026 年,它已经在哪些场景落地
1. 内容创作一人闭环
写脚本、生成配图、配音、剪视频,过去要三到五个人配合。现在一个人用多模态工作流就能跑完。小红书、抖音、B 站、公众号的内容生产,正在被重新定义。
2. 电商商品素材自动化
上传一张产品图,AI 自动生成多场景效果图、卖点文案、口播脚本、短视频。一天能做过去一周的量。
3. 教育与培训
教材里的图、视频、语音讲解可以互相跳转。学生问一道题,AI 能结合图示分步骤讲解,而不是纯文字堆答案。
4. 医疗与工业检测
结合影像、病历文本、语音问诊,多模态 AI 能给出更全面的辅助判断。在工业场景里,它能同时看监控画面、听设备声音、读传感器数据,综合判断异常。
三、为什么 2026 年是爆发点
几个关键能力同时成熟了:
- 理解能力:模型不再只是把图片”看”成像素,而是能识别图里的关系、场景、情绪。
- 生成能力:文生图、图生视频、文生视频的质量达到可用级别,不再只是玩具。
- 上下文长度:能一次性处理更长的视频、更多的图片,做真正复杂的任务。
- 成本下降:API 价格持续走低,个人和小公司也用得起。
四、普通人怎么用上多模态 AI
不需要懂算法。2026 年已经有大量工具把多模态能力封装好了:
- 图文混排创作:一句话生成带图文章、PPT、海报。
- 短视频工作流:文案 → 分镜 → 配音 → 视频,全流程 AI 辅助。
- 智能客服升级:用户发图片、语音,AI 都能理解并回应。
- 个人知识库:把截图、录音、PDF、网页全丢进去,AI 能跨模态检索。
最关键的技能不是 prompt 工程,而是学会把不同模态的工具串成工作流。
五、多模态的边界与幻觉
多模态 AI 也有幻觉。比如它可能看错图里的细节、听错语音、把视频内容张冠李戴。涉及安全、医疗、金融的关键决策,仍然需要人工复核。
另外,生成能力越强,版权和伦理问题也越突出。用 AI 生成真人形象、克隆声音,必须注意合规和授权。
六、写在最后
多模态 AI 真正改变的不是某个单一工具,而是”创作和理解的入口”。以前我们靠键盘和屏幕与机器交互,现在我们用图片、语音、视频和机器对话。
对普通人来说,2026 年最大的机会不是成为算法专家,而是成为那个最会把这些能力组合起来、解决具体问题的人。